Microsoft tester om multimodale modeller faktisk forstår rom
Microsoft Research har publisert MindTopo, en ny eval for multimodale språkmodeller som tester noe virksomheter ofte antar at modellene allerede kan: forstå romlige relasjoner som må bevares når verden endrer seg. Det høres smalt ut. Det er det ikke.
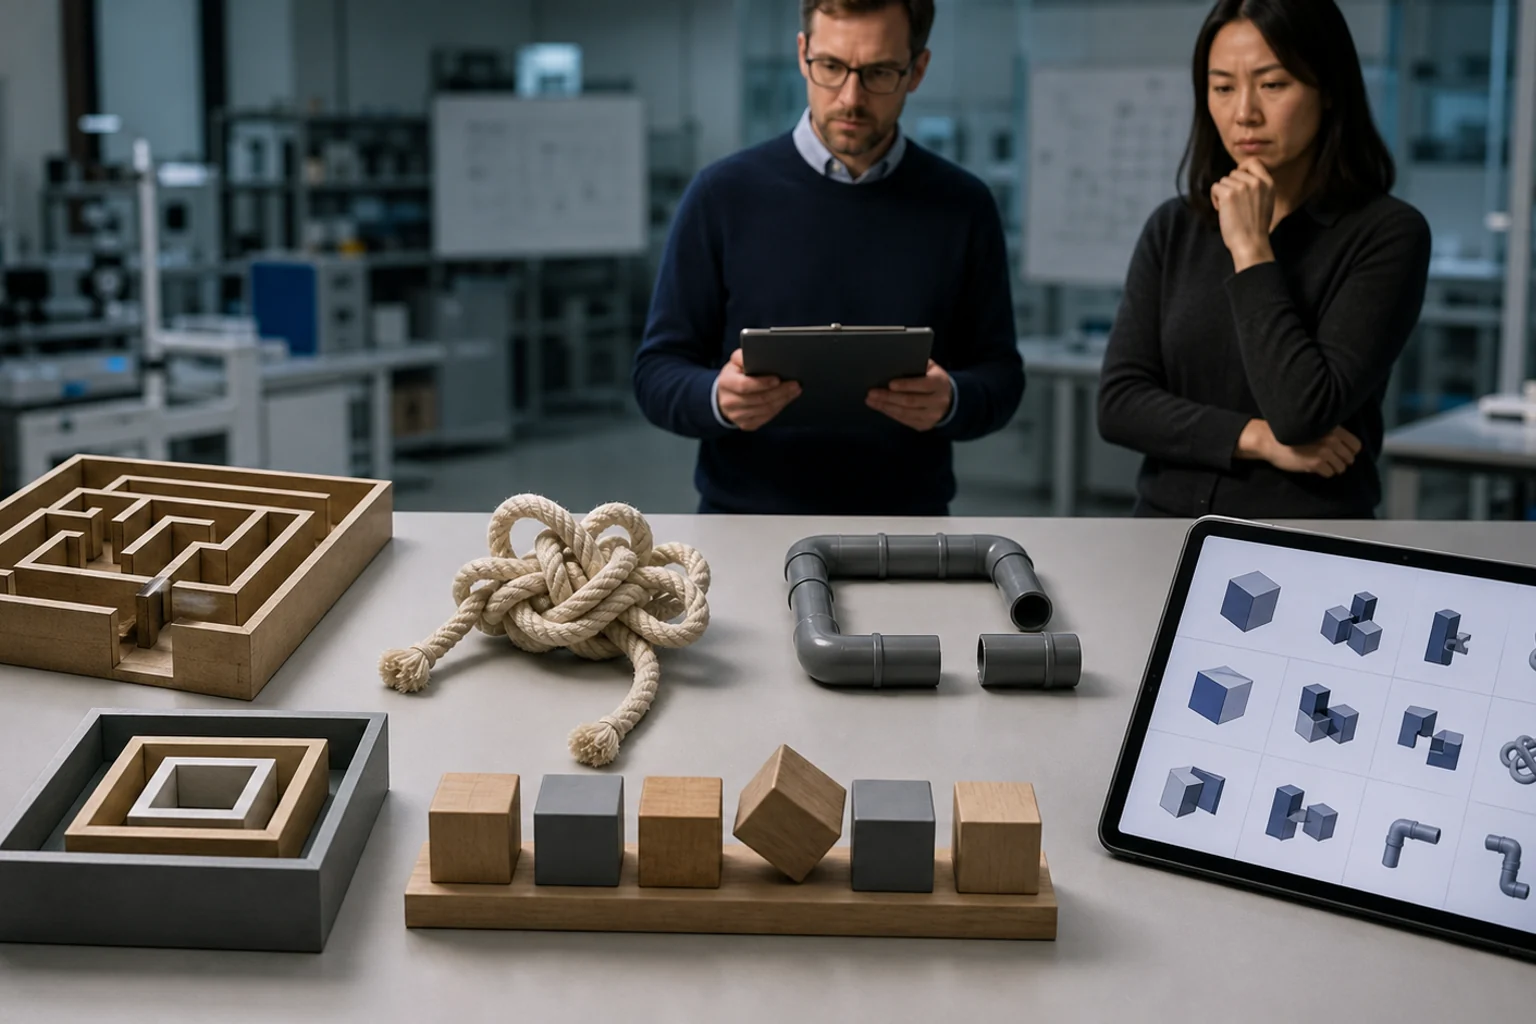
MindTopo handler ikke om om en modell kan si at en kopp står til venstre for en laptop. Den typen romforståelse er allerede overtestet. Evalen går dypere: Kan modellen forstå at to punkter fortsatt henger sammen etter at en vegg flyttes? At et dyr er innenfor et gjerde? At en løkke faktisk er en knute? At en rekkefølge må bevares når objekter bytter plass? Dette er topologisk romforståelse, altså struktur som består selv om former bøyes, strekkes eller flyttes.
Det viktige funnet er skillet mellom å se og å handle. Microsoft skriver at modellene gjør det bedre på statiske resonneringsoppgaver enn på interaktiv planlegging. De kan ofte svare riktig når relasjonen er synlig i ett bilde. Men når de må velge en serie handlinger, bevare en relasjon og ta hensyn til konsekvensene av egne trekk, faller ytelsen tydelig. Det er akkurat denne overgangen fra bildeanalyse til handling som avgjør om visuelle AI-agenter blir nyttige i produksjon.
For CIO-er og produktledere er dette en nyttig kald dusj. Mange agentstrategier bygger på en implisitt antakelse om at en multimodal modell som kan beskrive en skjerm, et kart, en fabrikkcelle eller en prosessflyt også kan styre handlinger i samme miljø. MindTopo sier: ikke så fort. Å gjenkjenne strukturen i et øyeblikksbilde er ikke det samme som å bevare strukturen gjennom en arbeidsflyt.
Evalen dekker fem kategorier: kontinuitet, separasjon, orden, innhegning og knuter. Den gjør dette på to nivåer. Først får modellene resonneringsoppgaver, der de må svare på visuelle spørsmål om renderede scener. Deretter får de planleggingsoppgaver i simulerte miljøer, der handlingene må skape, fjerne eller bevare bestemte romlige relasjoner. Miljøene håndhever lovlige handlinger. En modell kan altså ikke jukse seg gjennom et tauproblem ved å late som at en streng passerer gjennom en annen.
Dette gjør MindTopo mer interessant enn enda et generisk multimodalt scorekort. Microsoft bruker kontrollerte simulatorer med fasit. Det gjør det mulig å skille mellom to ulike feil: modellen så feil i bildet, eller modellen forstod scenen, men klarte ikke å holde relasjonen stabil mens den planla. Den forskjellen betyr mye når AI flyttes fra chat og søk til robotikk, tilgjengelighet, operasjonell støtte og visuelle arbeidsflater.
Feilmønsteret er også praktisk relevant. I statiske oppgaver starter feil ofte som persepsjonsfeil: modellen overser en åpning, en vegg eller en kryssing. I planlegging oppstår feil selv etter at scenen er forstått. Modellen velger et lokalt plausibelt trekk, men mister den langsiktige konsekvensen. Den holder ikke invarianten i hodet. For en leder betyr det at «modellen så skjermen riktig» ikke er et tilstrekkelig akseptansekriterium for computer-use, robotstyring eller visuelle agenter.
Microsoft testet også om generative bilde- og videomodeller kunne hjelpe. Svaret er blandet. Bildegenerering kan hjelpe når den relevante relasjonen finnes i ett enkelt bilde. Video-rollouts er svakere fordi de ofte endrer selve topologien eller bryter miljøets dynamikk. Det peker mot et større problem i dagens AI-arkitektur: visuell simulering er bare nyttig hvis den bevarer strukturelle begrensninger. Hvis modellen lager en pen video der tauet plutselig går gjennom seg selv, har den ikke løst planleggingen. Den har laget en illusjon.
Dette treffer spesielt tre områder. Først robotikk og fysisk automatisering, der agenten må forstå at objekter er koblet, låst, innelukket eller i en bestemt rekkefølge. Deretter tilgjengelighet, der AI skal hjelpe mennesker med å navigere rom, grensesnitt og objekter uten å skape farlige misforståelser. Til slutt enterprise computer-use, der visuelle agenter skal arbeide i komplekse apper med tilstand, skjemaer, avhengigheter og irreversible handlinger.
Den ledermessige konsekvensen er enkel: ikke kjøp multimodale agentløfter uten domene-evaluer. Hvis leverandøren selger «vision + action», må testene dine inneholde sekvenser, ikke bare skjermbilder. De må måle om modellen bevarer tilstand, forstår begrensninger og oppdager når en handling ødelegger strukturen den egentlig skulle beskytte.
MindTopo er derfor ikke bare en akademisk benchmark. Den er en påminnelse om at AI-agenter trenger mer enn språk, syn og verktøykall. De trenger en form for stabil verdensmodell. Microsoft antyder selv to mulige retninger: modeller som bærer eksplisitt topologisk tilstand, eller verdensmodeller som er konstruert slik at prediksjonene bevarer topologi. Begge deler er langt mer krevende enn å koble en VLM til et handlings-API.
For virksomheter som vurderer visuelle agenter nå, bør dette inn i innkjøpskravene. Be leverandører dokumentere ytelse på oppgaver som ligner deres faktiske arbeidsflyt: lager, produksjon, feltservice, bygg, helse, sikkerhet, CAD, kart, skjemaer eller komplekse SaaS-grensesnitt. Test lange handlingskjeder. Test feiloppretting. Test at modellen ikke bare kan peke på problemet, men bevare riktig struktur mens den forsøker å løse det.
Dette er også et signal om hvor modellkappløpet går videre. De beste multimodale modellene vil ikke bare være de som beskriver bilder best. De vil være de som forstår hva som ikke kan endres når de handler. I virkelige prosesser er det ofte nettopp det som skiller en assistent fra en risiko.
Kilder og medier
Primærkilde: Microsoft Research Blog – https://www.microsoft.com/en-us/research/blog/mindtopo-reveals-vlms-spatial-reasoning-abilities/
Discovery-signal: Microsoft Research på X – https://x.com/MSFTResearch/status/2087571058559693167
Thumbnail: OpenAI Image 2 / hogby.ai
📬 Likte du denne?
AI-nyheter for ledere. Kuratert av en CIO som bygger det selv. Daglig i innboksen.